






Репликация данных: от основ до выбора метода и облачных СУБД
Единственный сервер компании падает. В ту же секунду доставка еды в час пик теряет доступ к сведениям о заказах. Финтех-сервис не обрабатывает транзакции. Завод не получает данные из ERP, и конвейер останавливается. Итог один: простой, убытки, репутация под ударом. Именно для непрерывности и производительности важных сервисов существует этот механизм.
Количество пользователей растет, компании становятся всё более географически распределенными, требования к круглосуточной доступности и пиковые нагрузки создают вызовы для инфраструктуры. В любой момент могут случиться: отказ оборудования, сетевые задержки или перегрузка. Как сделать так, чтобы это не влияло на работу компании?
Репликация – это когда у базы данных (БД) есть несколько актуальных копий на нескольких узлах.
Правки с одной машины автоматически передаются на остальные. При отказе основной можно переключиться на копию, сократив время простоя. Запросы на чтение можно распределять между несколькими копиями, разгружая на каждый из них.
Важно! Это не резервное копирование. Бэкапы защищают архив информации. Репликация нужна для доступности сервиса и масштабирования в реальном времени.
В этом материале мы разберём:
- Что такое репликация данных
- Зачем нужна эта технология
- Как работает
- Архитектурные модели
- Виды репликации данных по способу синхронизации
- Физическая и логическая модель
- Репликация в популярных СУБД
- Проблемы и ограничения
- Репликация и шардирование: что выбрать
- Рекомендации по выбору метода репликации
- На что обратить внимание при выборе СУБД с поддержкой репликации
- Чек-лист: как выбрать метод репликации под свои задачи
Статья адресована администраторам БД и инженерам по эксплуатации, архитекторам приложений и техническим руководителям, владельцам цифровых продуктов, которые хотят повысить отказоустойчивость и производительность.
Материал позволит вам понять суть технологии, оценить, какие методы и архитектура оптимальны для вашей инфраструктуры, а также решить, какие задачи можно делегировать провайдеру.
Для внедрения рассматриваемой в статье технологии необязательно строить инфраструктуру с нуля – публичное облако Softline предлагает настройку репликации виртуальных машин, а также экспертный консалтинг по проектированию отказоустойчивых кластеров. Решение можно дополнить механизмами резервного копирования в облако и службой аварийного восстановления в облаке для комплексной защиты.
Что такое репликация данных
Технология существует, чтобы отказ одного сервера не останавливал весь бизнес. Подробнее о базовых понятиях.
Определение и ключевые принципы репликации данных
С точки зрения облачной инфраструктуры это не простое копирование сведений, а автоматическая синхронизация изменений между узлами, которая повышает отказоустойчивость, доступность и надежность работы БД.
Главное, что дает такая синхронизация – непрерывную доступность сервисов для пользователей. Автоматическое переключение при сбое источника на приемника обеспечивает стабильную работу даже при пиковом трафике и географической удалённости клиентов.
Пример репликации данных: интернет-магазин в чёрную пятницу. Тысячи людей одновременно листают сайт, сравнивают цены, читают отзывы. Если все запросы идут на один сервер – он перегревается, корзина не открывается. Клиенты уходят к конкурентам. Но если основной не выдерживает, а система переключает трафик на копию, то пользователи ничего не замечают. Так бизнес не теряет выручку.
Ключевой принцип в том, что любые модификации (вставки, удаления) фиксируются на ведущем устройстве, а затем в той же последовательности передаются на реплики. Это необходимо, чтобы поддерживать согласованность дублей с учетом выбранного способа синхронизации. На практике этот принцип реализуется через разные технические подходы, которые мы разберём далее.
Основные цели и задачи
Цель – создание и поддержание актуальных копий информации на нескольких узлах. Благодаря этому достигается непрерывная доступность бизнес-процессов, удается снизить риски потери информации и оптимизировать работу с пользователями.
Основные задачи технологии репликации данных:
- синхронизировать правки – своевременно переносить их с мастера на слэйвы;
- сокращать отставание – ускорять доступ пользователей;
- балансировать – разгружать главный сервер за счет распределения операций выборки;
- автоматически переключаться – переходить на резервную копию при сбое основного устройства;
- поддерживать горячий резерв – держать в режиме полной готовности к принятию трафика;
- консолидировать – собирать информацию в единый центр для аналитики;
- изолировать контуры – разделять тестовуюи продакшн-среду для безопасного тестирования;
- мигрировать – обновлять СУБД без остановки сервиса.
Зачем нужна эта технология
Ниже три основных причины, почему компании применяют ее.
Повышение отказоустойчивости
Первая задача – избежать простоев и потерь информации. Если головной узел выходит из строя, потому что сломалось оборудование, случился программный сбой или авария в дата-центре, сервис переключится на резервный экземпляр. Он сохранит пользовательские подключения практически в режиме реального времени.
Сравните: при резервном копировании бэкапы обычно делаются всего раз в сутки.
Масштабирование нагрузки и распределение запросов
Способность системы расти за счет добавления новых узлов особенно ценна при пиковом трафике. Ведомые распределяют запросы между собой, разгружая источник. Так производительность остается на высоком уровне даже при интенсивном росте трафика.
Резервирование и географическая доступность
Размещение копий в разных дата-центрах сокращает сетевое отставание, так как пользователи направляются к ближайшему устройству. Это ускоряет обмен сведениями между геораспределенными регионами и повышает устойчивость к локальным катастрофам.
Кроме клиентских сервисов в компаниях есть корпоративные приложения: ERP, CRM, СЭД и др. Запросы к ним могут выполняться на подчиненных машинах, чтобы не нагружать ведущий. Особенно часто это применяется для сложных аналитических платформ, так как они обрабатывают огромные информационные массивы и строят тяжелые отчеты.
Как работает
События, происходящие на главном узле, должны быть переданы на подчиненные для поддержки консистентности и отказоустойчивости. Рассмотрим механизм поэтапно.
Основной сервер и реплики
Сначала источник (лидер, master) передает по сети состояние всей БД, чтобы приемник получил актуальную базу. Дальше лидер переходит к непрерывной трансляции потока преобразований. В этот поток попадают:
- операции записи (например, менеджер внес заказ в CRM)
- обновление информации (сотрудник изменил статус заявки с «в работе» на «выполнена»).
- выполнение операций (клиент оплатил товар на сайте, банк списал деньги, а сервис создал заказ).
Реплики (ведомые, slave) постоянно подключены к мастеру по сети. Задача – принимать поступающие пакеты с корректировками и последовательно применять их к своей локальной копии. Так их состояние синхронизируется с головным сервером с минимальной задержкой.
Синхронизация данных и журнал транзакций
Ключевой элемент, отвечающий за надежность процесса – это журнал транзакций. В PostgreSQL он называется WAL (Write-Ahead Log) в MySQL Binary Log (бинарный лог) в MySQL.
Перед тем как изменение будет применено к основным файлам на мастере, платформа обязательно фиксирует его в журнале. Ведомые подключаются к лидеру, читают из этого журнала последовательность операций и воспроизводят их у себя.
Переключение на резервный узел
Когда на источнике случается сбой, нужно передать роль «мастера» одной из реплик. Такой процесс называется фейловером. Переключение может быть инициировано как вручную администратором, так и автоматически – через внешний менеджер кластера (например, Patroni, Corosync/Pacemaker или встроенные механизмы вроде MySQL MGR).
Алгоритм действий при этом стандартизирован:
- обнаружение сбоя – система мониторинга фиксирует недоступность мастера по таймауту ответа или недоступность порта;
- выбор нового лидера – из подчинённых устройств выбирается то, которое по истории журнала транзакций получил максимальное количество модификаций от упавшего мастера;
- продвижение – Slave переводится в режим Master. База перестаёт принимать входящий поток бинарных логов и начинает принимать запросы от клиентов;
- перенастройка остальных – ведомые перенаправляются на нового лидера;
- переключение клиентского трафика – DNS-записи, балансировщики перенаправляют все запросы с IP-адреса старого мастера на IP-адрес нового. Этот шаг часто делают одновременно с продвижением или чуть раньше, чтобы минимизировать время простоя (RTO).
Архитектурные модели
Первый вопрос, который возникает у инженера: «Как именно организовано взаимодействие между узлами?». Ответ на него и есть архитектурная модель. Разберём, чем на практике отличаются популярные архитектурные подходы.
Master-Slave (источник-реплика)
Это классическая схема репликации базы данных, при которой операции фиксации происходят на ведущей машине. Ведомые копируют правки из его журнала и отдают их для считывания.
Плюсы: относительно просто настраивается и можно добавить сколько угодно реплик для равномерного распределения запросов.
Минусы – единая точка отказа. Если ведущая машина выйдет из строя, нужно будет через внешний оркестратор или дополнительные автоматические механизмы повышать слейв до уровня мастера. При этом существует вероятность потери еще не синхронизированных транзакций.
Когда применимо: если операций чтения на порядок больше, чем записи, и вы готовы к ручному или автоматизированному (через внешние инструменты) переключению лидера. Идеально для CRM, программ для управления складом, блогов, любых сервисов, где строгая консистентность важнее доступности.
Multi-Master (источник-источник)
Здесь каждый сервер может быть как источником, так и принимающей стороной. Любой может принимать запросы на правки, которые затем синхронизируются между всеми участниками.
Плюсы модели в возможности оптимально распределять операции между всеми и высокой отказоустойчивости. Выход из строя одной машины не остановит процесс, так как его можно продолжить на любой другой.
Минусы – сложно достичь согласованности. Когда один и тот же объект одновременно изменяется на разных узлах, возникают конфликты. Например, цену товара в Москве меняют на 150, а в Санкт-Петербурге в ту же секунду – на 200. Программа не может сама разрешить такой спор. Ей требуются внешние механизмы: правила приоритета, сравнение временных меток, а чаще вмешательство прикладного кода, который перечитывает конфликтующую версию и предлагает пользователю выбрать правильное значение.
На практике встроенной Multi-Master модели нет в популярных системах управления БД. В PostgreSQL и MySQL реализуется только через дополнительные расширения. В результате задержки транзакций возрастают, так как требуется синхронное согласование. Это делает модель менее подходящей для географически распределенных сервисов со значительным отставанием между дата-центрами.
Когда применимо: модель Multi-Master выбирают для сервисов, где критически важна непрерывность записи и недопустима единая точка отказа. На практике это решение оправдано, когда бизнес-требования к доступности перевешивают издержки на сложность разрешения конфликтов и мониторинга.
Безмастерная (Leaderless)
Здесь нет главного сервера – все равны. Запросы отправляются на запись всем и ждут подтверждения от большинства. При чтении также опрашивается несколько узлов, чтобы найти самый свежий по временным меткам.
Плюсы: можно потерять половину машин, и работа продолжится без ручного переключения.
Минусы: плата за «живучесть» – сложность. Необходимо отслеживать конфликты. Чем больше машин в кластере, тем выше риск, что цепочка синхронизации даст сбой.
Когда применимо: модель подходит если постоянная доступность важнее, чем мгновенная актуальность, например, для корзин покупок, логов или управления сессиями пользователей.
Виды репликации данных по способу синхронизации
От способа синхронизации зависит, когда и как изменения с источника попадают на дубли. Чтобы понять, какой подход выбрать для своей задачи, нужно разобраться в трех ключевых методах синхронизации.
Синхронная
Источник завершает операцию, только когда ведомые подтверждают получение и апдейт. Клиентское приложение ждет ответа дольше. Зато его массив информации уже сохранен минимум на двух независимых устройствах.
Синхронный вид выбирают, когда потеря информации дороже любой задержки. Это обязательное условие, например, для банковских и платежных систем, торговых платформ.
| Преимущества | Недостатки |
|---|---|
| Сохранность информации (RPO, близкий к 0) | Запись тормозится самым медленным узлом |
| Упрощенный механизм переключения при сбоях | Может увеличить отставание |
| Строгая согласованность | Хуже подходит для геораспределенных кластеров (зависит от настроек) |
| Высокие затраты на инфраструктуру и каналы |
Асинхронная
Мастер фиксирует транзакцию и сразу возвращает клиенту подтверждение, не дожидаясь ответа от других. Информация передается на реплики в фоновом режиме, поэтому клиент получает максимально быстрый отклик. При этом система сохраняет высокую производительность даже в особо нагруженном режиме. Однако если мастер выйдет из строя до синхронизации, последние транзакции будут потеряны.
Асинхронный вид выбирают, когда скорость важнее сохранности отдельного события. Период репликации данных в этом режиме напрямую зависит от сетевой задержки и текущей загрузки мастера. Подходит для высоконагруженных интернет-проектов, соцсетей, новостных порталов, аналитических инструментов.
| Преимущества | Недостатки |
|---|---|
| Минимальная задержка | Риск потери последних транзакций в случае сбоя ведущего зла |
| Высокая производительность | Приемники могут отставать от мастера |
| Легко масштабируется | Усложненный фейловер с возможной потерей содержимого |
| Низкие требования к сети и каналам связи |
Полусинхронная
Мастер ждет подтверждения, что изменение получено и перенесено в журнал, хотя бы от одной реплики. После этого транзакция фиксируется, и клиент получает ответ.
Компромисс: вероятность, что информация потеряется в случае сбоя лидера, меньше, но скорость записи выше, чем при полной синхронизации. Если никто не подтвердит получение за отведенное время, в некоторых реализациях мастер автоматически переключается в асинхронный режим, предотвращая остановку приложений.
Полусинхронный вид выбирают, когда нужен баланс между надежностью и производительностью. Популярное решение для большинства корпоративных платформ (CRM, ERP, WMS) и облачных СУБД по умолчанию.
| Преимущества | Недостатки |
|---|---|
| Баланс скорости и надежности | При задержке сети запись тормозится сильнее асинхронной |
| Нет потерь при сбое мастера | Требует быстрого и стабильного канала между устройствами |
| Автоматическое переключение в асинхронный режим при проблемах с ведомыми | Slave может отставать |
| Подходит для большинства корпоративных платформ | Работает хуже для удаленных серверов с медленными сетями |
Физическая и логическая модель
Дальше опишем три ключевых подхода, которые чаще всего встречаются в реальных проектах, чтобы понять, какие виды репликации баз данных подходят именно вам.
Блочная
Копирование физических блоков диска целиком. Создаётся полная аппаратная копия всего тома – ОС, файлы, БД и служебная информация дублируются как единый массив. Работает на уровне «железа». Не требует установки ПО на серверах, но копирует абсолютно все, включая неактуальные и временные файлы.
Применяют для аварийного восстановления всей инфраструктуры, когда дублирование средствами СУБД недоступно или требуется копирование legacy-систем. Не подходит для распределения трафика или выборочного копирования.
Физическая
WAL-журнал передается от мастера к реплике на уровне СУБД. Приемник проигрывает записи и становится побайтовой копией БД. Физический вид работает внутри одной СУБД, обычно предъявляет строгие требования к идентичности версий, но передаёт только WAL-журнал, а не все файлы, при этом трафик меньше блочной.
Применяется для создания горячего резерва с быстрым переключением (1-2 минуты), масштабирования и снятия трафика с мастера. Идеально для OLTP, где критична отказоустойчивость и консистентность.
Логическая
Работает на уровне логических объектов: таблиц, строк и отдельных операций. В отличие от блочной и физической, логическая передает не всю БД целиком, а только выбранные операции: вставка, обновление, удаление строк с их фактическими значениями.
Нужна для выгрузки части сведений в аналитические инструменты, миграций между СУБД, интеграций с отчётными платформами и построения сложных топологий. Для отказоустойчивости обычно не применяют из-за задержек.
Методы логической репликации
1. Триггерный механизм
Специальные процедуры (триггеры) перехватывают изменения и дублируют новые строки в служебную таблицу логов. Далее они отправляются к внешним агентам. Автономный подход гибко фильтрует информацию на лету. Минус – снижает общую производительность БД из-за двойной нагрузки на дисковую подсистему при каждой операции.
2. Журнальный метод
Этот метод репликации данных непрерывно анализирует штатные бинарные логи СУБД, декодирует их в логические команды и транслирует на целевую точку в реальном времени. Источник работает быстрее, однако такая схема требует прав суперпользователя и критично зависит от совпадения версий ПО.
3. CDC-платформы
Внешние коннекторы автоматизированно собирают модификации: преобразуют транзакционные логи БД в стандартизированные потоки событий для их публикации в брокерах сообщений. Архитектура идеально подходит для масштабной синхронизации разнородных инструментов вроде SQL, NoSQL и аналитических хранилищ. Чтобы развернуть ее нужна поддержка сложной дополнительной инфраструктуры.
4. На стороне приложения
За синхронизацию отвечает код программы, которая при любой бизнес-операции самостоятельно дублирует запросы во все целевые базы. Метод дает разработчикам контроль и независимость от вендоров. Только алгоритмы защиты от сетевых сбоев и рассинхронизации приходится программировать вручную.
Репликация в популярных СУБД
От выбора программного комплекса зависят архитектура, надёжность и цена эксплуатации. Сравнительная таблица «Как осуществляется репликация данных в реляционных БД» поможет оценить популярные – PostgreSQL, MySQL и MS SQL Server.
| Критерий | PostgreSQL | MySQL | MS SQL Server |
|---|---|---|---|
| Базовая архитектура | Primary – Replica | Primary – Standby и Subscriber | Publisher – Subscriber |
| Базовые типы репликации баз данных | Физическая и логическая | Логическая по журналу изменений | Логическая |
| Синхронность по умолчанию | Асинхронная и синхронная | Обычно асинхронная, возможны дополнительные варианты | Асинхронная |
| Механизмы передачи | WAL – Write-Ahead Log | Binary Log (binlog) | Log Reader и Distribution Agent |
| Форматы | WAL и логические правки строк | Statement-Based (SBR)Row-Based (RBR)Mixed | Снимки, транзакции, слияние изменений |
| Гибкость схемы | Высокая | Средняя | Высокая |
| Фейловер | Внешний (Patroni, repmgr) | Внешний (Orchestrator, MHA, ProxySQL) | Встроенный автоматический |
| Согласованность | Высокая (при синхронной) или средняя (при асинхронной) | Средняя (в асинхронном варианте) или выше средней (в полусинхронном режиме) | Высокая (синхронный Always On с фиксацией лога на диске) или средняя (асинхронный режим). |
| Задержка | Минимальная (в потоковом физическом режиме) или средняя (в логическом режиме при тяжелых транзакциях) | Низкая (при построчной RBR) или средняя (при инструктивной SBR из-за повторного выполнения тяжелых запросов) | Минимальная (в Always On за счет работы на уровне ядра) или Средняя (в Pub/Sub из-за цепочки агентов и базы Distributor) |
| Сложность настройки | Средняя | Низкая/средняя | Высокая/средняя |
Репликация в PostgreSQL
Репликация базы данных PostgreSQL сочетает два уровня: физический – для быстрого и надёжного копирования кластера, и логический – для более точечной передачи сведений. Это делает ее хорошим выбором там, где одновременно нужны отказоустойчивость, выборочная синхронизация и возможность развивать архитектуру без привязки к одной схеме. На практике PostgreSQL чаще подходит там, где нужно не только резервирование, но и инструмент архитектурной гибкости.
Репликация в MySQL
Репликацию данных My SQL выбирают за прямолинейную и предсказуемую модель «источник – приемник». Сильная сторона – простота внедрения и эксплуатации, а также удобство для масштабирования чтения и консолидации информации из нескольких источников. При этом MySQL менее гибка, чем PostgreSQL, если речь идёт о сложной избирательной синхронизации или нестандартных архитектурных схемах.
Репликация в MS SQL Server
MS SQL Server выделяется разнообразием встроенных сценариев: от периодической доставки снимков до слияния изменений. Удобна для крупных компаний, контуры которых могут требовать разного режима синхронизации и администрирования. Главный плюс SQL Server – набор механизмов и зрелость Enterprise-подхода. Минусы – сложное сопровождения и зависимость от выбранной архитектуры.
Отказоустойчивость MS SQL можно повысить с помощью кластеризации. Особенно если мы говорим про сценарии активного обращения из приложения в геораспределенных структурах. Кластер, как правило, представляет собой три одинаковые БД, которые постоянно обмениваются информацией. При наплыве работы на одну из них часть потоков перераспределяются на две другие. После нормализации вновь происходит переключение на одну.
Также кластер – это организационная структура, которая позволяет обновлять ПО, проводить доработки, донастройки и другие работы без остановки работы приложения. Кластер как структура защищает от простоя и перегрузок, повышает эффективность и скорость работы приложения. Наиболее часто кластеры используются в CRM и ERP, в которых единовременно может работать большое количество пользователей, аналитиков и разработчиков. Классический пример – приложение 1С. В средних и крупных компаниях кластер – это стандарт и необходимость. Он строится нативными средствами и не требует закупки и установки дополнительного ПО.
Проблемы и ограничения
У технологии есть и риски. Ниже их основные категории.
Отставание дублей
При асинхронном варианте мастер подтверждает транзакцию до применения преобразований на репликах – возникает временной разрыв. Пользователи видят устаревшие сведения, и есть риск потери при сбое лидера.
Как решить?
Чтобы минимизировать задержки, применяют полусинхронную технологию. Выделяют отдельные копии под разные типы нагрузки и внедряют мониторинг с оповещениями. В некоторых облачных сервисах управляемые БД (RDS) поддерживают автоматическое создание реплик для MySQL и PostgreSQL, что упрощает распределение трафика без ручной настройки инфраструктуры.
Проблемы консистентности
Устаревшее чтение – когда свежая транзакция не видна приемнику. Нарушение монотонного чтения – запросы пользователя возвращают то актуальную, то старую версию. Нарушение согласованного префиксного чтения – правки применяются в неверном порядке, нарушая причинно-следственные связи. В мультимастер-топологиях возникают конфликты параллельных корректировок.
Как решить?
Проблемы решаются сессионной консистентностью, кворумными стратегиями, версионированием транзакций и детерминированными правилами разрешения конфликтов. В «Софтлайн Облако» система репликации данных синхронизирует БД в реальном времени с проверкой согласованности параметров между исходной и целевой БД, что снижает риск расхождений.
Усложнение администрирования
Распределенная архитектура требует мониторинга, отслеживания задержек и загрузки каждого узла. Управлять ими становится сложнее – корректировки структуры таблиц должны быть совместимы со всеми приемниками. Добавляются процессы переключения при сбоях и разрешения ситуации «split-brain». Трудозатраты команды увеличивается, как и стоимость владения.
Как решить?
Эффективное управление строится на внедрении оркестраторов, программ мониторинга и использовании управляемых облачных сервисов. Решения «Софтлайн Облака» снимают большую часть работы: RDS обеспечивает автоматическое резервное копирование и переключение при отказах между зонами доступности, а услуги аварийного восстановления позволяют развернуть копии виртуальных машин на удаленной площадке с минимальным участием администратора.
Репликация и шардирование: что выбрать
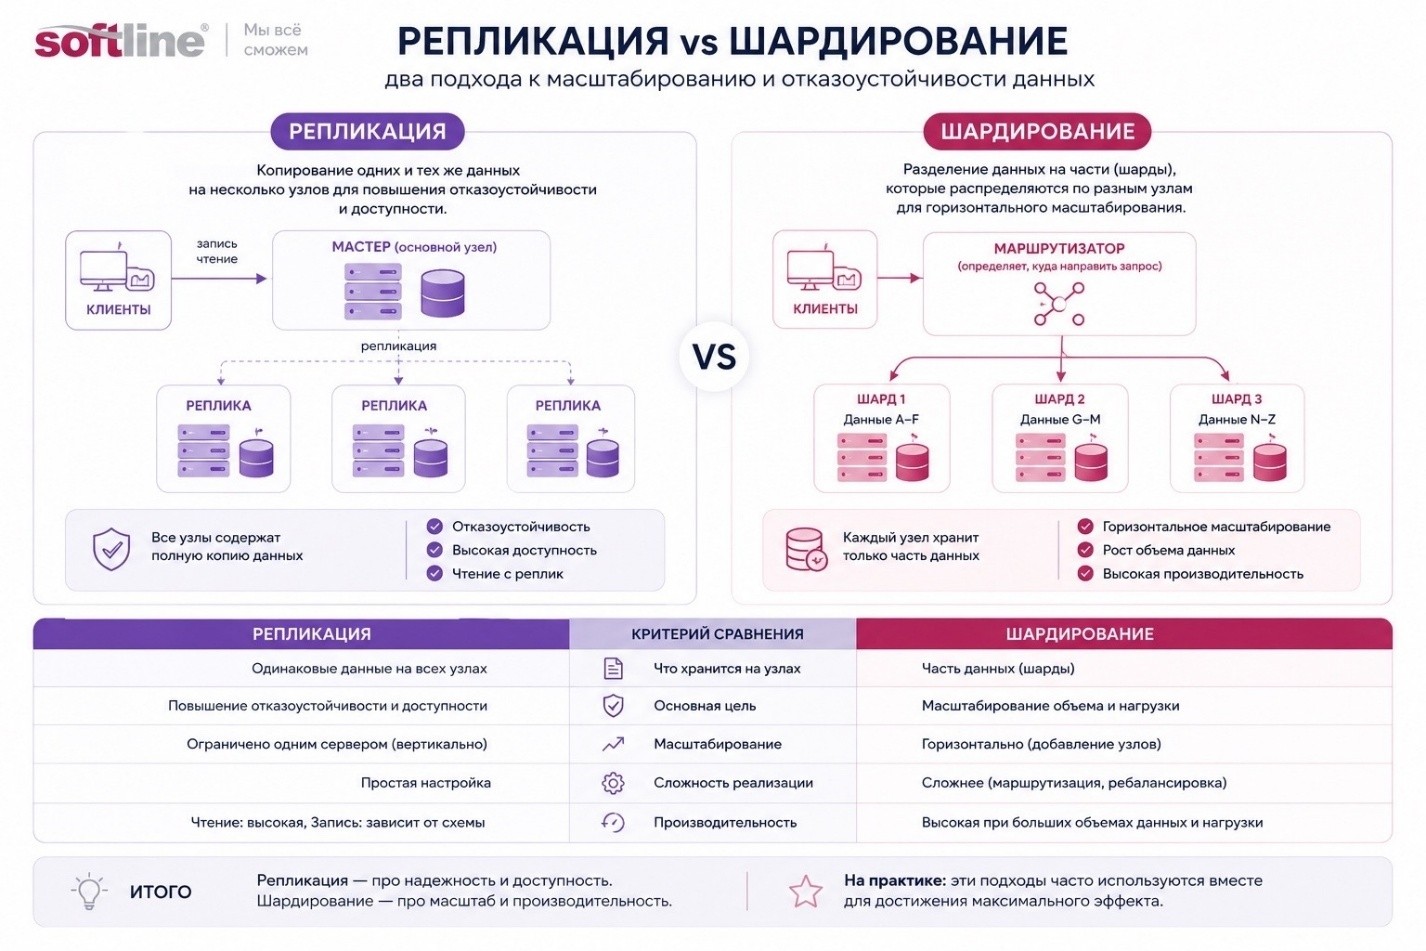
Процессы решают разные задачи. Первый повышает отказоустойчивость и ускоряет считывание, второй – масштабирует при росте объема операций. Во многих крупных сервисах эти технологии сочетают.
Когда эффективна репликация
Подходит, если:
- сервис должен работать при отказе оборудования;
- запросов на чтение много и нужно их ускорить;
- время простоя при авариях необходимо сократить.
Выбирайте, если основная проблема надежность и производительность существующей БД.
Когда эффективно шардирование
Применяют, когда:
- база уже не помещается на одном сервере;
- резко растет количество пользователей и запросов;
- вертикально масштабировать слишком дорого или невозможно.
Выбирайте, если узким местом стали размер БД и общий поток запросов на систему.
Комбинированный подход
Чем больше нагружены корпоративные инфраструктуры, тем чаще используется сочетание обеих технологий: информация распределяется между несколькими машинами (шардирование), а каждый шард дополнительно реплицируется.
Такой подход дает:
- масштабируемость;
- отказоустойчивость;
- высокую производительность;
- возможность дальнейшего роста без перестройки архитектуры.
Рекомендации по выбору метода репликации данных
Что выбрать – зависит от требований бизнеса и ресурсов на сопровождение инфраструктуры.
Определение бизнес-требований
Ответьте:
- Какое время простоя допустимо?
- Насколько критична потеря?
- Что преобладает – чтение или запись?
- Планируется ли рост трафика?
Вопросы помогут определить требования к отказоустойчивости, производительности и архитектуре БД.
Выбор подходящего типа и архитектуры
Выбирайте архитектуру под свои задачи.
- Master-Replica – для отказоустойчивости и скорости приема сведений.
- Multi-Master – если запись должна выполняться одновременно из нескольких машин.
- Шардирование с репликацией – для крупных высоконагруженных систем, где важно и масштабирование, и высокая доступность.
Если организация не может сама управлять инфраструктурой, можно рассмотреть репликацию и восстановление данных в облаке Softline. Там механизмы репликации данных, высокая доступность и обслуживание платформы уже реализованы на уровне сервиса. С ними можно быстрее внедрить решение и снизить операционные затраты. Настройка репликации данных в облачной среде сводится к выбору нужной конфигурации через интерфейс управления – без необходимости разворачивать и обслуживать кластеры вручную.
Мониторинг и тестирование
Даже правильно выбранная архитектура требует постоянного контроля. Нужно отслеживать:
- задержку;
- состояние узлов;
- производительность БД;
- корректность автоматического переключения при отказах.
Тестируйте сценарии отказа регулярно, чтобы выстроенная архитектура точно могла продолжить работу при сбоях.
Обеспечение целостности и резервное копирование
Репликация базы данных не заменяет резервное копирование. Для защиты необходимо сочетать:
- репликацию данных между серверами для непрерывной работы;
- регулярное резервное копирование;
- проверку возможности восстановления.
Управляемые БД можно дополнить сервисами резервного копирования и аварийного восстановления. Так выстраивается отказоустойчивая архитектура с единым контуром защиты.
На что обратить внимание при выборе СУБД с поддержкой репликации
От платформы зависят скорость и надежность приложения в условиях интенсивной работы.
Поддерживаемые режимы
- Синхронный: снижает вероятность потери, но увеличивает отставание записи.
- Асинхронный: максимальное быстродействие, но риск потери последних транзакций при сбое.
- Топология: Master-Slave подходит для масштабирования чтения, а Multi-Master – для записи, но требует разрешения конфликтов.
- Облачная: альтернатива сложной внутренней настройке – инфраструктура в «Софтлайн Облаке». Сервис гарантирует стабильность критичных бизнес-приложений с RTO и RPO от нескольких минут.
Автоматизация отказоустойчивости
- Failover: роли автоматически переносятся при падении мастера. Оценивайте время переключения и софт автоматизации (Patroni, Orchestrator).
- Split-Brain: защита от рассинхронизации при разрыве сети с помощью алгоритмов консенсуса (Raft, Paxos) и кворума.
- Проверка кластера: надежность проверяется тестами. Панель управления vCloud Director и изолированная песочница от «Софтлайн Облака» позволяют регулярно тестировать планы восстановления.
Производительность и масштабируемость
- Replication Lag: слейв отстает от мастера. При интенсивных запросах от пользователей лаг может расти, выдавая пользователям устаревшие сведения.
- Сетевой трафик: сколько и как передаются WAL-логи. Эффективное сжатие логов между удаленными ЦОД критично.
- Экспертная поддержка: обслуживание кластеров требует штата инженеров. Перенос инфраструктуры в «Софтлайн Облако» (SLA до 99,99%, поддержка 24/7) помогает поддерживать прозрачную стоимость эксплуатации.
Чек-лист: как выбрать метод под свои задачи
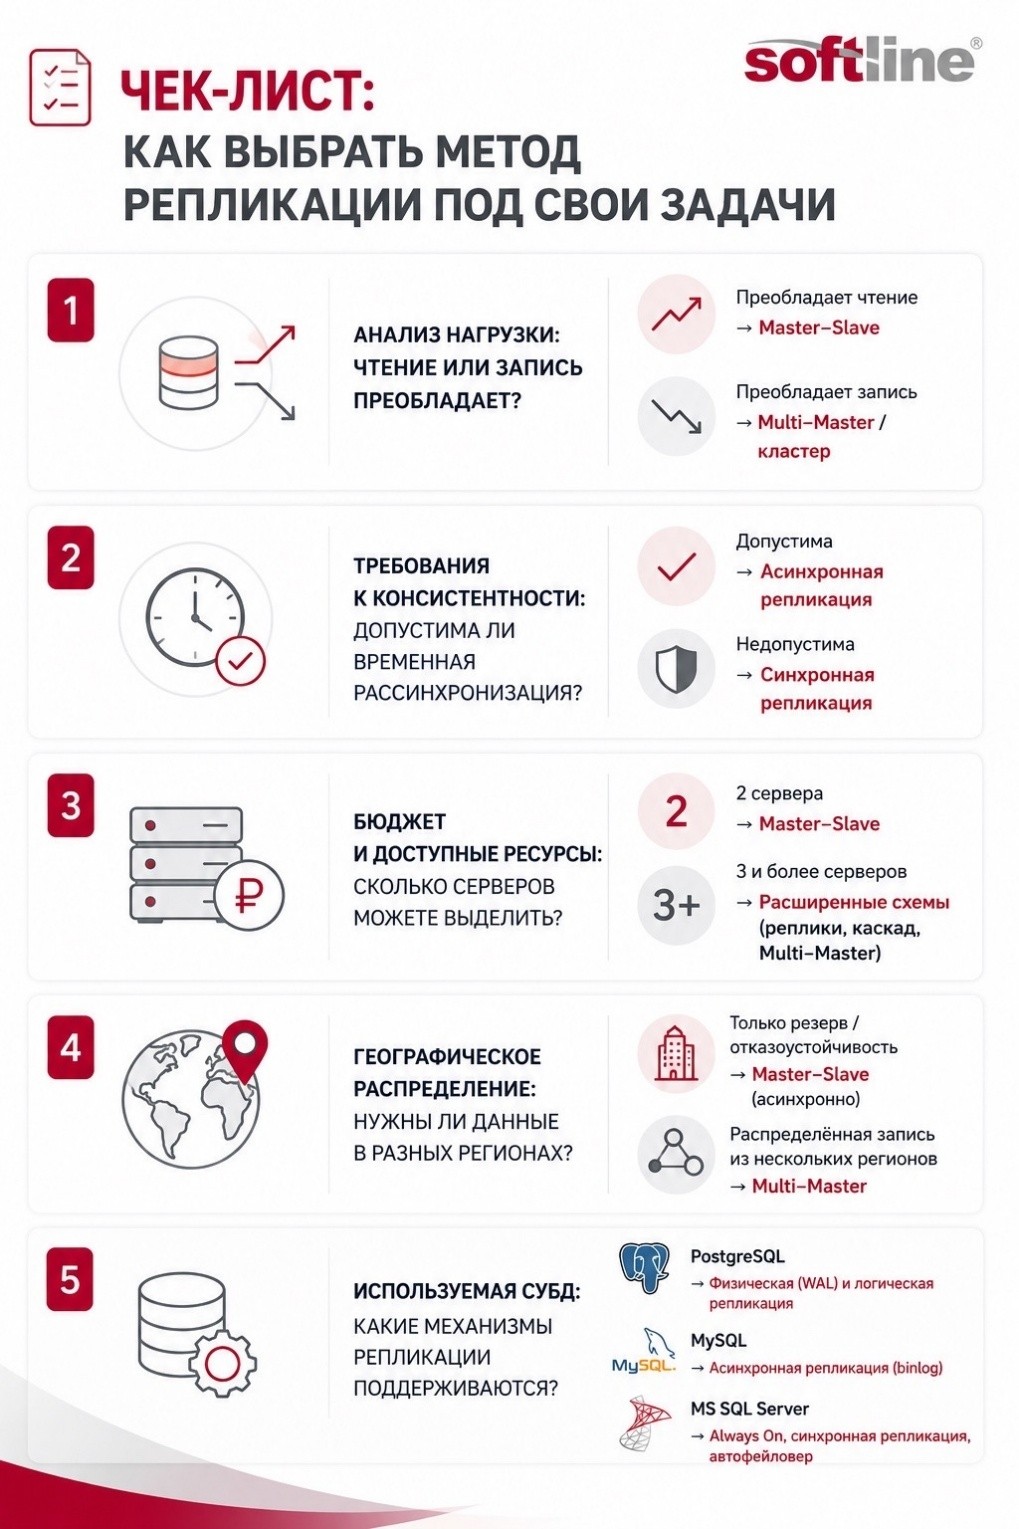
Анализ нагрузки: преобладает чтение или запись?
Если преобладают операции чтения (например, новостной портал), чаще выбирают модель Master-Slave. Мастер обрабатывает запись, а несколько слейвов распределяют между собой запросы, разгружая лидера. Когда процессы интенсивны или критически важны (например, в платёжных платформах) потребуется более сложная архитектура, например Multi-Master или кластерное решение, чтобы избежать единой точки отказа для операций модификации.
Требования к консистентности: допустима ли временная рассинхронизация?
Если скорость отклика важнее абсолютной актуальности каждой транзакции, допустима временная рассинхронизация. В таких случаях подойдет асинхронный механизм, который даёт максимальную производительность, но допускает отставание. В критически важных системах, напротив, рассинхронизация исключена: синхронный вариант при корректной настройке может достичь RPO, близкое к нулю, но может увеличивать задержку.
Бюджет и доступные ресурсы: сколько серверов можете выделить?
Если бюджет ограничен и инфраструктура небольшая, подойдёт классическая схема Master-Slave. Одна машина под запись, вторая под чтение и горячий резерв. При трех и более серверах открываются варианты с отдельными репликами для отчётов, каскадной или Multi-Master моделью. В зависимости от реализации логический тип (CDC) может требовать больше ресурсов и быть сложнее в администрировании. Синхронные режимы между удалёнными ЦОД могут нуждаться в дорогих выделенных каналах связи.
Географическое распределение: нужны ли данные в разных регионах?
Обычно реплики располагаются в дата-центрах, близких к филиалам компании, чтобы сокращать сетевые задержки и поддерживать катастрофоустойчивость. Реализуется это с помощью топологии Master-Slave с асинхронным процессом, где Slave выступает горячим резервом и принимает трафик при сбое основного ЦОД. Когда требуется распределённая география на несколько регионов, подходит Multi-Master, но могут быть сложности с разрешением конфликтов и рост задержек синхронизации.
Используемая СУБД: какие механизмы поддерживаются?
PostgreSQL поддерживает и физическую, и логическую репликацию, а MySQL стандартно работает с асинхронным видом на основе бинарных логов и проще в настройке для базовых сценариев. MS SQL Server предлагает встроенный механизм Always On с автоматическим фейловером и синхронной Data Replication на уровне ядра, что делает его предпочтительным для enterprise-уровня, но требует более высокой квалификации администраторов.
Заключение
Правильно спроектированная репликация данных минимизирует риски простоев, потери сведений и помогает поддерживать стабильный пользовательский опыт даже при пиковых загрузках и нештатных ситуациях.
Преимущества внедрения
- Отказоустойчивость – автоматическое переключение при сбое источника для продолжения работы критических сервисов.
- Балансировка – распределение запросов повышает производительность в разы и снижает нагрузку на ведущее устройство.
- Географическая доступность – размещение реплик в разных регионах сокращает задержки для локальных пользователей и защищает от катастроф на уровне ЦОД.
- Гибкость масштабирования – возможность добавлять read-приемников «на лету», адаптируя инфраструктуру под растущий бизнес без остановки сервиса.
- Комплексная защита – сочетание репликации с резервным копированием создает многоуровневую архитектуру безопасности.
Для реализации всех преимуществ необходима надежная облачная платформа, предлагающая поддержку различных моделей, автоматизированное управление отказоустойчивостью и экспертную поддержку на всех этапах – от проектирования до эксплуатации.
Напишите экспертам «Софтлайн Облака», чтобы подобрать оптимальную конфигурацию под ваши задачи. На странице продуктов доступны примеры архитектур, калькулятор стоимости и возможность заказа пилотного проекта. Компания реализует мультивендорный подход, объединяя решения большинства вендоров в едином окне для всех задач. За комплексную защиту отвечают сервисы:
- Резервное копирование в облако (BaaS)
- Аварийное восстановление в облаке (DRaaS)
- Публичное облако Softline (IaaS)
Решения создадут единый контур защиты для работы вашего бизнеса.
